SQL Server langsam? Wir finden die Ursache.
Performanceprobleme in SQL-Server-Anwendungen sind unser Tagesgeschäft: akut, gezielt, umgesetzt oder dauerhaft. Jeden Befund belegen wir, jede Änderung messen wir nach.
Kommt Ihnen das bekannt vor?
Seit dem Update langsam
Nach einem Release, einem Versionswechsel oder einer Konfigurationsänderung läuft es spürbar anders.
Sporadische Hänger
Manchmal steht das System, meist nicht. Bis jemand nachsieht, ist die Spur verschwunden.
Hohe Last ohne klaren Grund
CPU oder I/O am Anschlag, ohne dass Nutzerzahl oder Datenmenge das erklären.
Blockierungen & Deadlocks
Sitzungen warten aufeinander, Transaktionen brechen ab, Nutzer melden Fehler.
Nächtliche Jobs werden zu lang
Wartung, Importe oder Berichte passen nicht mehr in ihr Zeitfenster.
Mehr Hardware half nicht
Mehr Cores, mehr RAM, schnellerer Speicher, und das Problem ist immer noch da.
Akut, gezielt, umgesetzt, dauerhaft.
Performance Troubleshooting
Kurzfristig helfen, Ursache eingrenzen, Sofortmaßnahmen abstimmen.
Mehr → GezieltPerformance-Analyse
Strukturiert untersuchen und priorisierte Empfehlungen liefern.
Mehr → UmsetzenPerformance Tuning
Änderungen umsetzen, mit Rückweg einspielen und die Wirkung nachmessen.
Mehr → DauerhaftPSG MX
Kontinuierliches Performance Engineering im vereinbarten Umfang.
Mehr →Wenn es brennt, zählt eine belastbare Spur.
Wir unterstützen kurzfristig, oft schon per Teams- oder Zoom-Sitzung mit geteiltem Bildschirm. Erst stabilisieren, dann die Ursache belegen, damit das Problem nicht wiederkommt.
„Mich beeindruckt in der Zusammenarbeit mit PSG neben der außerordentlichen, praxiserprobten Expertise vor allem die Möglichkeit, kurzfristig Unterstützung zu erhalten.“
- Lage aufnehmen
Was ist betroffen, seit wann, was hat sich zuletzt geändert? - Eingrenzen
Wartezeiten, Blockierungen, Pläne und Ressourcen im laufenden System ansehen. - Sofortmaßnahmen
Mit Ihnen abgestimmt und mit klarem Rückweg. - Ursache belegen
Evidenz sichern, damit die eigentliche Ursache behoben werden kann. - Befund
Kurz dokumentiert: was war, was wurde getan, was ist noch offen.
Strukturiert untersuchen, priorisiert empfehlen.
Sie möchten das ganze System prüfen lassen, nicht nur die Performance? Dann ist der SQL Server Health Check der passende Weg. Der Performance-Audit ist einer seiner Zuschnitte.
- 01
Anamnese
Anwendung, Nutzung, Auffälligkeiten und bisherige Maßnahmen verstehen.
- 02
Konfiguration
Instanz, Datenbanken, Speicher und Wartung auf Plausibilität prüfen.
- 03
Kennzahlen
Wartezeiten, Ressourcen und Trends im Zusammenhang lesen.
- 04
Workload & Pläne
Die teuersten und auffälligsten Abfragen und ihre Ausführungspläne untersuchen.
- 05
Empfehlungen
Priorisiert, begründet und mit einem Weg, die Wirkung zu prüfen.
anamnese      Antwortzeiten im Monatsabschluss deutlich schlechter als im Rest des Monats.
konfiguration Parallelität und Speicher plausibel, Statistikwartung unregelmäßig.
kennzahlen    Wartezeiten überwiegend beim Lesen großer Datenmengen.
workload      Wenige Berichtsabfragen verursachen den Großteil der Last.
pläne         Fehlende Filterung vor einem großen Join, ungünstige Schätzung.
empfehlung    Index und Abfrageänderung testen, Wirkung im nächsten Abschluss vergleichen.
Ändern, was wirkt. Und belegen, dass es wirkt.
Eine Empfehlung zählt erst, wenn sie umgesetzt ist und ihre Wirkung feststeht. Wir spielen Änderungen nach Ihrer Freigabe selbst ein oder begleiten Ihr Team und den Hersteller dabei. Nachgemessen wird in jedem Fall.
Noch keine belegten Ursachen? Dann beginnt das Tuning mit einer Performance-Analyse oder einem Performance-Audit.
- 01
Änderungsplan
Maßnahmen nach erwarteter Wirkung, Risiko und Aufwand ordnen. Eine Änderung nach der anderen, damit sich jede Wirkung zuordnen lässt.
- 02
Testen
Auf einem Testsystem oder mit vergleichbarer Last prüfen: gleiches Ergebnis, erwarteter Plan, keine Nebenwirkung auf andere Abfragen.
- 03
Einspielen mit Rückweg
Nach Ihrer Freigabe im vereinbarten Fenster, durch uns oder Ihr Team. Wie es zurückgeht, steht vorher fest.
- 04
Nachmessen
Dieselben Abläufe vor und nach der Änderung vergleichen: Laufzeit und Ressourcenverbrauch der betroffenen Abfragen, dazu die Nebenwirkungen auf andere.
- 05
Festhalten
Was geändert wurde, warum und mit welcher Wirkung, damit Betrieb und Entwicklung es später nachvollziehen können.
Sechs Stellhebel, eine Reihenfolge.
Die meisten Performanceprobleme lösen sich in der Workload, nicht in der Hardware. Deshalb arbeiten wir uns von der Abfrage zur Plattform vor und ändern die Hardware erst, wenn die Workload effizient ist.
Abfragen & Code
Ungünstige Muster wie zeilenweise Verarbeitung oder Funktionen auf Spalten in Filterbedingungen. Oft bringt eine kleine Umformulierung mehr als jeder Index.
Indizes & Statistiken
Fehlende, doppelte oder ungenutzte Indizes, veraltete Statistiken. Jeder zusätzliche Index kostet beim Schreiben, deshalb prüfen wir Vorschläge gegen die ganze Workload.
Pläne & Parameter
Dieselbe Abfrage, ein anderer Plan: Parameter Sniffing, Schätzfehler, Planwechsel nach Updates. Wir stabilisieren gezielt, statt Pläne pauschal festzunageln.
Optimizer verstehen →Parallelität & Konfiguration
MAXDOP und Cost Threshold passend zur Workload, dazu Speicher und tempdb. Ziel ist kürzere Laufzeit bei effizientem CPU-Einsatz, nicht eine kleinere Wartezeitstatistik.
Tor und Breite →Sperren & Nebenläufigkeit
Blockierungen, Deadlocks und lange Transaktionen. Isolationsstufen, Zugriffsreihenfolge und Transaktionsgrenzen passen wir gemeinsam mit der Entwicklung an.
Plattform & Ressourcen
Wenn die Workload effizient ist und trotzdem nicht reicht: CPU, Speicher und Storage passend dimensionieren, Edition und Cores bewusst wählen.
Edition & Cores →Die Statistik war richtig. Ein alter Plan stand im Weg.
Eine zentrale Listenansicht einer geschäftskritischen Anwendung reagierte träge. Was wir gefunden, geändert und gemessen haben, ohne eine Zeile Code der Anwendung zu ändern.
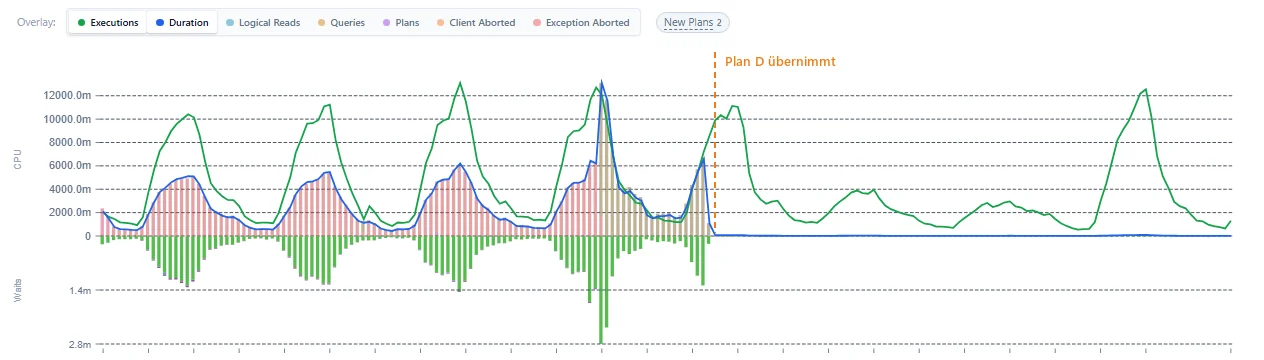
- Ausgangslage
Die Liste ruft eine Funktion millionenfach auf. Im Mittel kostete jeder Aufruf rund 15 Millisekunden, über den Tag summiert sich das zu spürbarer Wartezeit für die Anwender. - Erster Versuch
Eine gefilterte Statistik sollte dem Optimizer zu besseren Schätzungen verhelfen. Sie lief erst im Test, dann in Produktion. An den Messwerten änderte sich nichts. - Befund
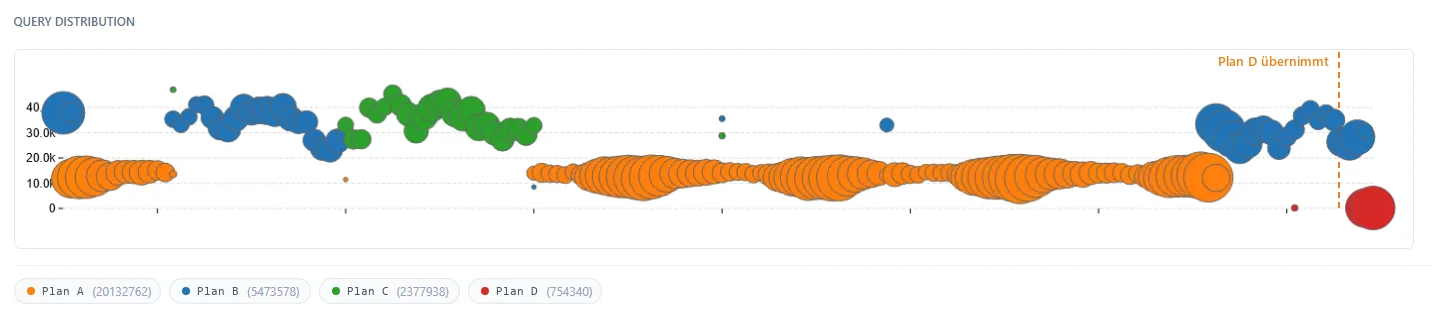
Für die Abfrage war im Query Store seit Langem ein Plan festgelegt. Wann und warum, ließ sich nicht mehr rekonstruieren. Die Festlegung hinderte den Optimizer daran, die neue Statistik zu nutzen. - Änderung
Festlegung gelöst und die Workload beobachtet. Der Optimizer fand einen deutlich besseren Plan, fiel aber gelegentlich auf einen alten zurück. Auf Grundlage der Ausführungshistorie hat das Team des Kunden den neuen Plan nach Abstimmung gezielt festgelegt. - Wirkung
Mittlere Laufzeit der Funktion von rund 15 auf 0,2 Millisekunden, verglichen über mehr als 8 Millionen und knapp 590.000 Ausführungen.
Was wir daraus mitnehmen: Plan-Festlegungen sind ein Werkzeug, kein Dauerzustand. Wir dokumentieren sie und prüfen sie regelmäßig. Änderungen an Festlegungen lassen sich mit einem Extended Event nachverfolgen. Hält der neue Plan nicht, bleibt ein Index auf dem Filterprädikat als Alternative.
Kontinuierliches Performance Engineering.
Für Anwendungen, bei denen Performance geschäftskritisch ist. Wir beobachten, untersuchen, verbessern und prüfen die Wirkung, Monat für Monat und im vereinbarten Umfang.
Zum Einstieg mindestens drei Monate als MX-Intensive, danach laufend als MX-Care. Mit MX AIOps und PSG QX, die in Ihrer Umgebung laufen und keine Daten in eine Public Cloud synchronisieren.
- Analyse & Zielsetzung
Gemeinsam festlegen, was „gut“ für Ihre Anwendung bedeutet. - Datenerfassung
Kontinuierlich und lokal, mit MX AIOps. - Optimierung & Reporting
Priorisierte Maßnahmen und ihre gemessene Wirkung. - Wissenstransfer
Damit Ihr Team die Zusammenhänge versteht.
Belege statt Bauchgefühl.
Seit über zehn Jahren entwickeln wir eigene Werkzeuge und überarbeiten sie laufend, um noch bessere Erkenntnisse zu liefern.
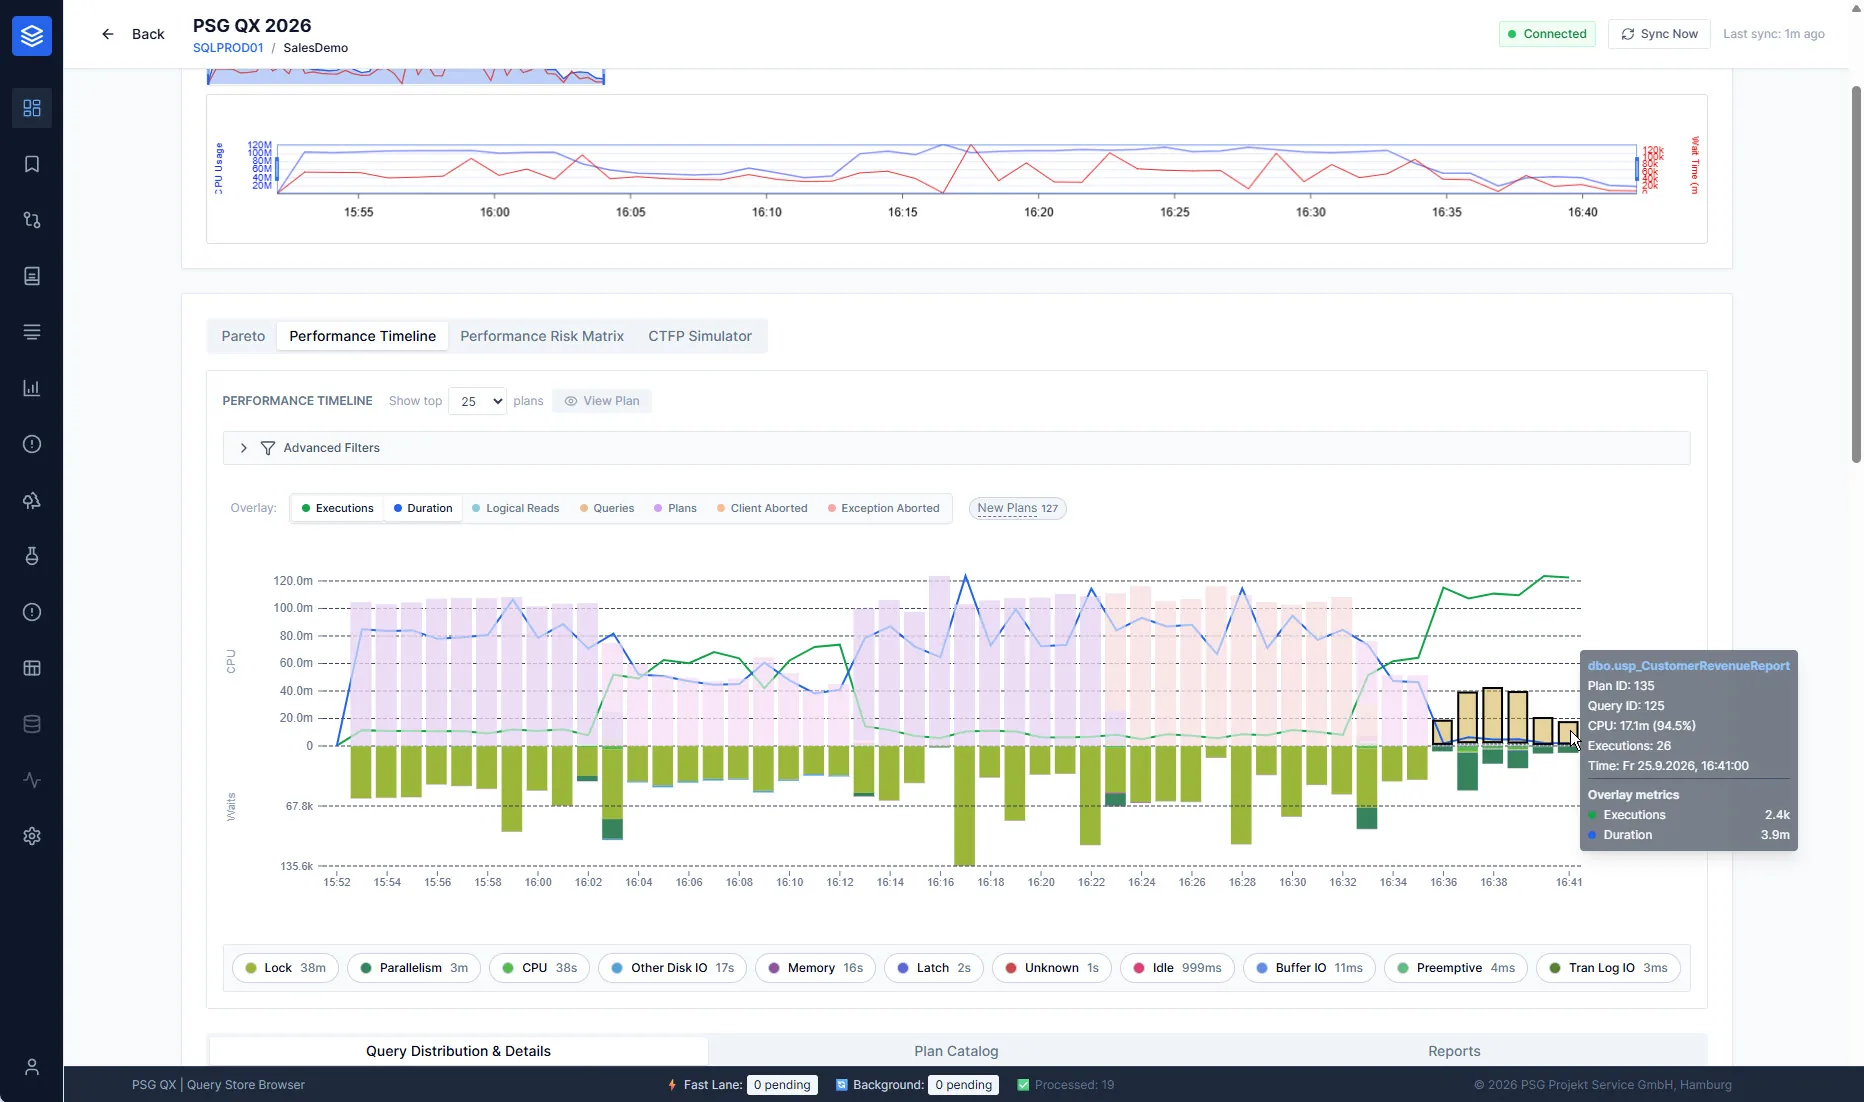
PSG QX
Analysiert die Ausführungshistorie: welche Abfrage, welcher Plan, seit wann, und was eine Änderung tatsächlich bewirkt hat.
QX Recorder
Hält die Evidenz sporadischer Probleme fest. Tritt das Problem nachts auf, liegen morgens die Daten vor.
MX AIOps
Erfassung und Auswertung für laufend betreute Umgebungen, mit nachvollziehbaren Regeln und statistischen Verfahren.
Kurz beantwortet.
Hilft nicht einfach mehr Hardware?
Manchmal. Oft verschiebt zusätzliche Hardware das Problem aber nur oder macht es teurer. Wenn die Ursache in Abfragen, Plänen, Indizes oder Datenzugriff liegt, hilft eine gezielte Änderung meist nachhaltiger.
Brauchen Sie Zugriff auf unsere Systeme?
Nicht unbedingt. Für schnelle Hilfe genügt oft schon eine Teams- oder Zoom-Sitzung: Sie teilen Ihren Bildschirm, wir schauen gemeinsam hin und geben Ihnen den entscheidenden Schubs in die richtige Richtung. Unsere Analysewerkzeuge laufen lokal in Ihrer Umgebung.
Wir haben bereits ein Monitoring. Wozu dann PSG?
Monitoring zeigt, dass etwas auffällig ist. Wir klären, warum, und was die wirksamste Änderung ist. Vorhandene Daten aus Ihrem Monitoring nutzen wir dabei gern als Ausgangspunkt.
Arbeiten Sie mit dem Softwarehersteller zusammen?
Ja. Wenn die Ursache in der Anwendung liegt, stimmen wir Befunde und Maßnahmen mit Ihnen und dem Hersteller ab.
Setzen Sie die Änderungen selbst um?
Je nach Absprache. Wir spielen Änderungen nach Ihrer Freigabe selbst ein oder begleiten Ihr Team und den Hersteller dabei. Die Nachmessung übernehmen wir in beiden Fällen.
Sollten wir die Index-Vorschläge von SQL Server einfach umsetzen?
Besser nicht ungeprüft. Die Vorschläge betrachten jeweils einzelne Abfragen, nicht die ganze Workload, und überschneiden sich oft. Jeder zusätzliche Index kostet bei Änderungen an den Daten. Wir prüfen, welche Vorschläge sich lohnen, und fassen sie wo möglich zusammen.
Wie messen Sie die Wirkung?
Wir vergleichen dieselben Abläufe vor und nach der Änderung, bevorzugt über die Ausführungshistorie im Query Store: Laufzeit und Ressourcenverbrauch der betroffenen Abfragen und mögliche Nebenwirkungen auf andere.
Wie wird abgerechnet?
Je nach Form als Projekt, über ein Beratungskontingent oder als laufende Vereinbarung mit PSG MX. Im ersten Gespräch klären wir, was zu Ihrer Situation passt.
Schildern Sie uns Ihr Problem.
Bei akuten Problemen am besten telefonisch. Im ersten Gespräch ordnen wir die Lage ein und schlagen den nächsten Schritt vor.