Zum Nachschlagen und aus der Praxis.
Oben unser Kompendium: Themen, die wir laufend pflegen und nach und nach erweitern. Darunter Beiträge und Fallberichte aus Projekten, Vorträgen und der Arbeit an unseren Werkzeugen. Sachlich, mit Belegen und mit ihren Grenzen.
Kompendium
Wird gepflegt statt veröffentlicht und vergessen: Jede Seite trägt ihren Stand, ihren Reifegrad und ein Änderungsprotokoll.
SQL Server Performance: Ursachen finden
Sechs Diagnosewege, wenn SQL Server langsam ist: Pläne und Parameter, Blocking und Timeouts, Last und Wartezeiten. Mit lesenden SQL-Abfragen und Beispielen aus unserem Lab.
Zum Ratgeber →SQL-Server-Versionen
Aktueller Build und Supportende für SQL Server 2005 bis 2025, vollständige Update-Listen je Version und ein Build-Prüfer für die Ausgabe von @@VERSION.
Optimizer verstehen
Warum dieselbe Abfrage mal schnell und mal langsam ist: echte Ausführungspläne zum Ausprobieren, Parameter Sniffing im Plan Cache und die Gegenmittel im Vergleich.
Kapitel 1 lesen →Beiträge & Fallberichte
Mehr Kerne, schnellere Kerne oder eine bessere Abfrage?
Wann mehr Kerne helfen, wann nur ein schnellerer Kern und wann die bessere Abfrage. Mit Laborbelegen und den Kennzahlen für einen echten CPU-Engpass.
Wird unsere Anwendung durch ein Upgrade schneller?
Ein Upgrade ändert drei Dinge: Engine, Kompatibilitätsgrad und neue Features. Wie Sie Gewinn und Risiko für Ihre eigenen Abfragen trennen, mit Labbelegen.
SQL Server Backup und Restore: die Grundlagen
Full, Differential oder Log? Lernen Sie SQL Server Sicherungen, einen geprüften Restore und den Einstieg mit Ola Hallengren kennen.
SQL Server Backup und Restore: den Ernstfall planen
Restore auf einen Zeitpunkt, COPY_ONLY, Logketten und Retention: So prüfen Sie SQL Server Backups und Ola Hallengren im Betrieb.
Gleiche Abfrage, anderes Tempo: sp_BlitzPlanCompare im Lab
Brent Ozars sp_BlitzPlanCompare im Lab auf SQL Server 2022 und 2025: was es findet, was die Befunde bedeuten und wie aus einem Unterschied eine Ursache wird.
Wenn der Index ohne Wartung wächst: Warum eine stabile Seitendichte keine Ruhe bedeutet
Warum eine stabile Seitendichte keine Ruhe im Index bedeutet: Zwei Indizes ohne jede Wartung bis 3,6 Millionen Zeilen stabilisierten sich in unserem Versuch um 68 % Seitendichte, mit weiter rund 225 Split-Logrecords je 10.000 Inserts. Dazu, wie sich die Kosten des Abwartens und Eingreifens vergleichen lassen.
Aufgeräumt, aber ohne Platz: REORGANIZE, REBUILD und die nächsten Inserts
Warum REORGANIZE in unserem Insertversuch kaum Split-Logrecords spart und ein REBUILD mit Reserve deutlich mehr bewirkt: Nach REORGANIZE 14.870 Split-Logrecords bei den nächsten 100.000 Inserts, nach REBUILD mit Fillfactor 81 nur 2.632. Gemessen auf SQL Server 2022 und 2025, mit Seitenverteilung, Kosten nach Recovery-Modell und 60-Tage-Vergleich.
Platz für die nächste Zeile: Wie ein Index Seiten liest, füllt und teilt
Neun Seitenbilder statt Formeln: Seiten und Wegweiser, Page Split, Fragmentierung, Seitendichte, Fillfactor, REORGANIZE, REBUILD und Statistiken. Und warum ein niedriger Fragmentierungswert allein noch keine gute Wartungsentscheidung ergibt.
Der Leser, der die Tabelle sperrt: SELECT, Prefetch und Lock Escalation
Gemessen auf SQL Server 2019, 2022 und 2025: warum ein SELECT unter READ COMMITTED Sperren festhält, wann es eskaliert und welche Gegenmittel wirken. Mit Röntgenbild und Quiz.
Beitrag lesen →Wo steckt die Zeit? Query Store bei Triggern, Procedures und Funktionen
Gemessen auf SQL Server 2019: wo sich Duration überlappt, wo Arbeit ohne eigenen Eintrag bleibt und warum Summen in die Irre führen. Mit Zeitraffer und Ratespiel.
Beitrag lesen →T-Lift: Dynamisches SQL, ohne es von Hand zu schreiben
Unser T-SQL-Precompiler macht aus Catch-all-Prozeduren parametrisiertes dynamisches SQL mit passenden Plänen. Der Quelltext bleibt lesbares T-SQL.
Artikel lesen →SQL Server Iceberg: Wie tief kommen Sie?
Das Browserspiel: am Eisberg entlang in die Tiefe tauchen, 15 echte Performance-Probleme lösen, ein Leben. Ganz unten wartet Cthulhu.
Abtauchen →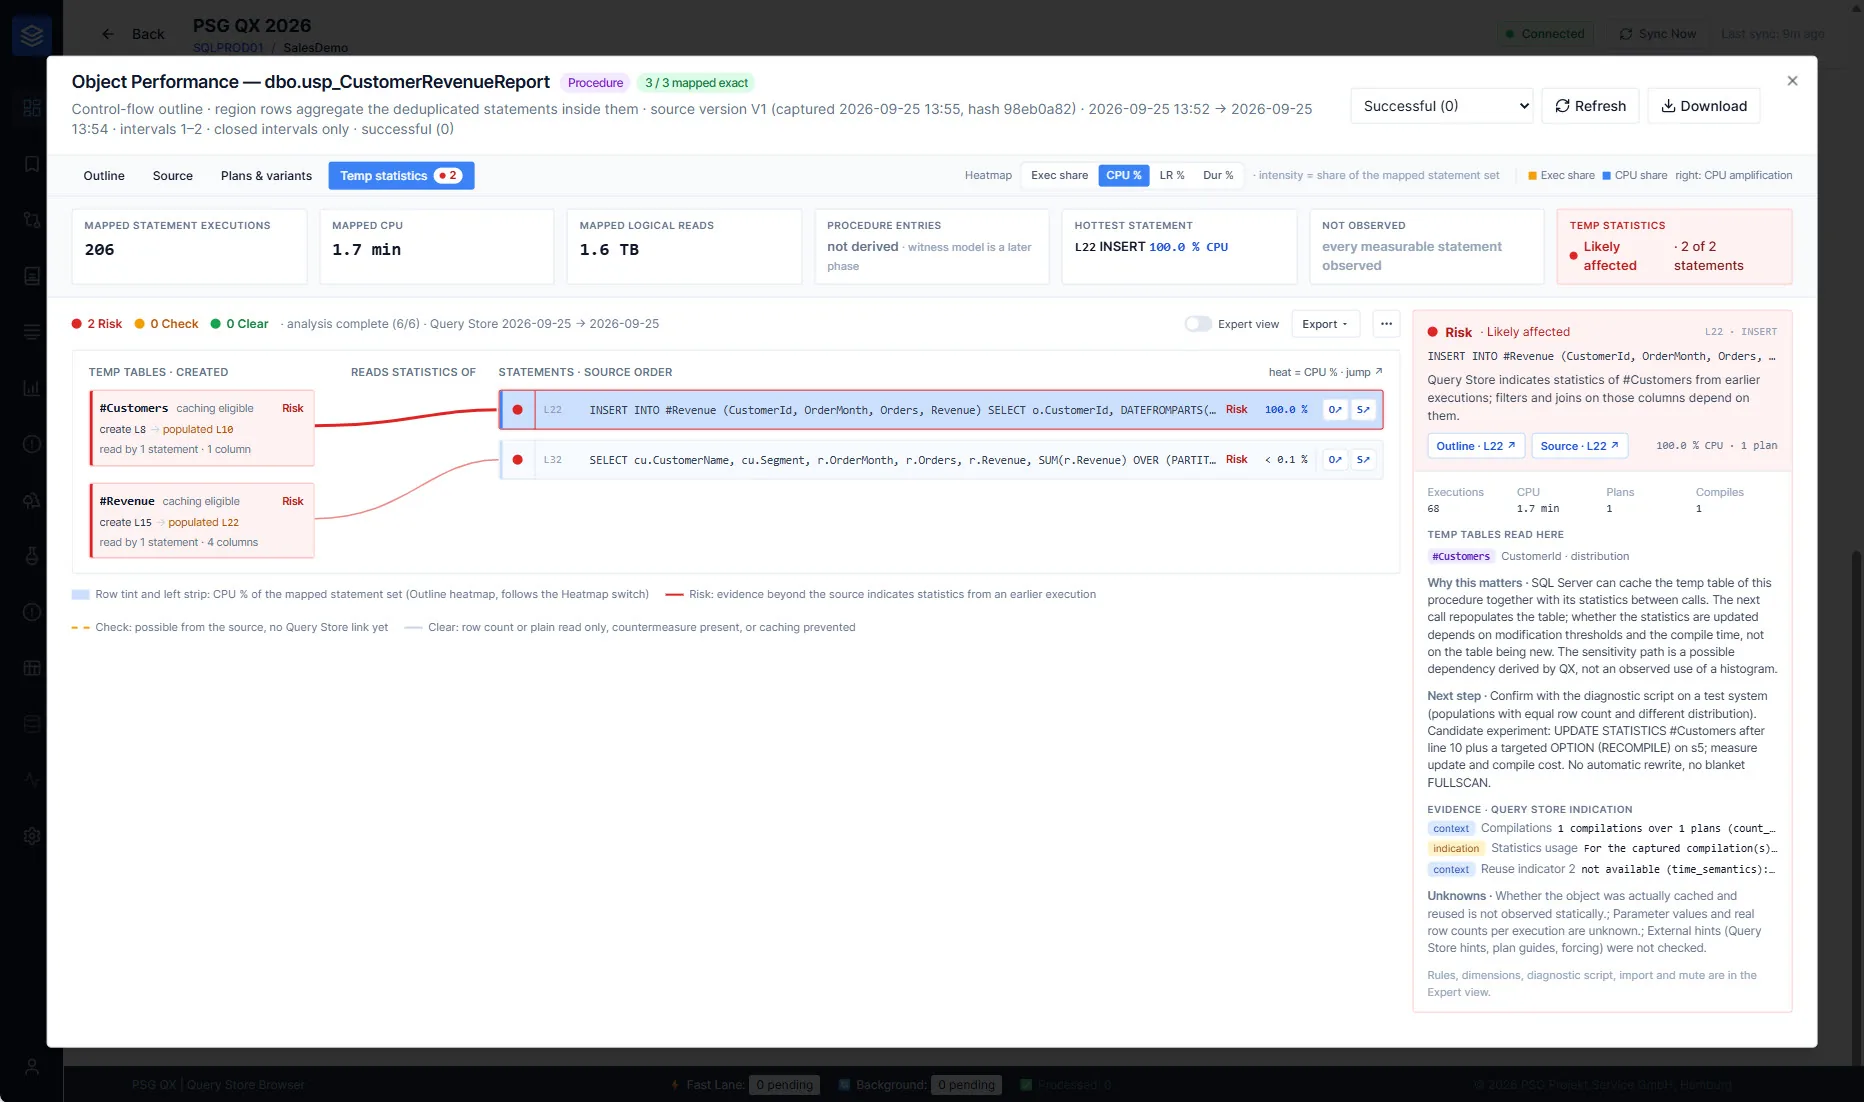
So sieht Evidenz aus
Ein Blick in PSG QX: vom Zeitverlauf über die teure Codezeile bis zum Befund mit Beleg, Unbekanntem und nächstem Prüfschritt.
Zum Einblick →Lokal. Deterministisch. Nachprüfbar.
Warum wir für Analysen auf Data Mining setzen, lange vor generativer AI, und was „deterministisch“ für Ihre Befunde bedeutet.
Weiterlesen →Die Statistik war richtig. Ein alter Plan stand im Weg.
Ein im Query Store festgelegter Plan hielt den Optimizer von einer neuen Statistik fern. Gefunden, gelöst und nachgemessen, ohne eine Zeile Anwendungscode zu ändern.
Zum Praxisfall →
Performance Driven Development
Performance in Entwicklung und Architektur von Anfang an mitdenken, statt sie im Betrieb zu reparieren.
Zu den Trainings →
Immer hart am Wind
Von 1994 bis heute: CeBIT 2008 auf der Microsoft-Bühne, Columnstore auf der Partner-Konferenz 2012, In-Memory OLTP seit 2015.
Zu den Meilensteinen →
Hamburger SQL Server Usergroup
Seit 2005 von uns organisiert, heute Microsoft Data Platform Community Hamburg.
Zu Meetup ↗